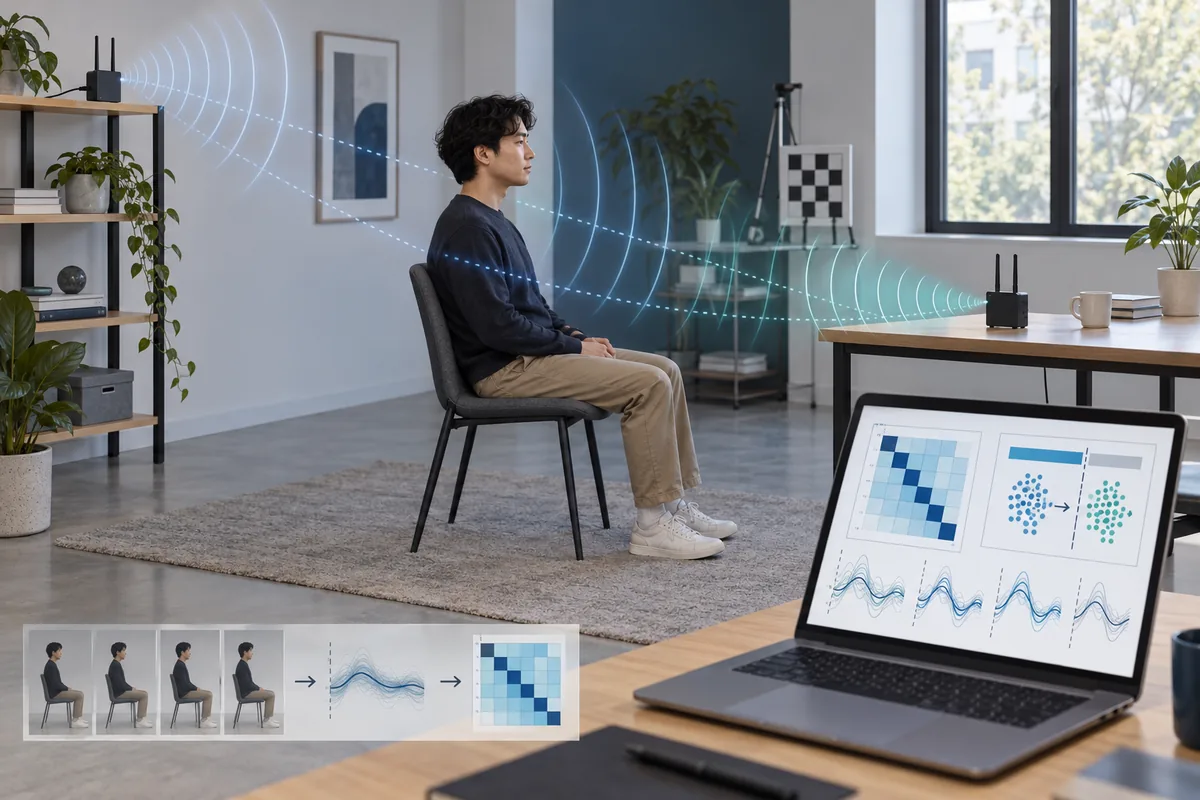
La precisión del sensado WiFi indica con qué frecuencia una inferencia coincide con una referencia definida. La inferencia puede ser presencia frente a ausencia, una clase de movimiento, una zona, un gesto, una tendencia respiratoria o una posición. Cada tarea necesita etiquetas, métricas y errores aceptables propios. Decir que un sistema tiene un 95 % de precisión sin nombrar la tarea y la partición oculta más de lo que explica.
El punto de partida práctico es escribir la afirmación antes de capturar CSI. Decide qué es positivo, qué coste tiene una falsa alarma, qué personas o habitaciones deben generalizar y si la salida es clasificación, regresión o una visualización de investigación. Conserva una grabación de referencia, un registro de etiquetas y una sesión separada que no se use durante el ajuste.
Esta guía se centra en una evaluación repetible de sensado WiFi: un informe transparente con montaje reproducible, fallos visibles y límites claros.
¿Qué significa realmente la precisión del sensado WiFi?
La precisión relaciona una predicción con una etiqueta de referencia. En detección de presencia, la etiqueta puede ser una habitación vacía u ocupada durante un intervalo. En reconocimiento de gestos, puede ser una clase con inicio y final marcados. En posicionamiento interior, puede ser una zona o coordenada medida con otra referencia. La señal de radio no es la verdad: es la observación que alimenta la inferencia.
El umbral cambia el significado de precisión: un detector que evita perder ocupantes puede producir más falsas alarmas. Indica tarea, etiquetas, umbral, ventana temporal y condiciones junto a cada métrica.
- Define primero una salida: clase, zona, coordenada, conteo o estimación continua.
- Nombra la etiqueta de referencia y el intervalo que se puntúa.
- Registra umbral, equilibrio entre clases y condiciones excluidas.
- Trata la precisión como evidencia condicionada, no como una propiedad permanente del dispositivo.
¿Qué métricas debe incluir una prueba de WiFi sensing?
Elige métricas que correspondan al coste de cada error. La precisión global es fácil de leer, pero puede esconder una clase rara o un detector que siempre elige la clase mayoritaria. Una matriz de confusión muestra qué clases se mezclan. La precisión indica cuántos positivos anunciados son correctos; el recall indica cuántos positivos reales se encuentran; F1 equilibra ambos. Con datos desiguales, el recall por clase o la precisión balanceada suele ser más útil que una cifra única.
Las tareas de regresión y localización necesitan otras medidas. Usa error absoluto medio, error mediano o un percentil para una distancia o una tasa. En posicionamiento por zonas, informa qué parte de las predicciones queda dentro de una tolerancia útil. No presentes una puntuación de clasificación como si fuera una medida en centímetros.
| Tarea | Métricas útiles | Qué revisar | Trampa habitual |
|---|---|---|---|
| Presencia binaria | Precisión, recall, F1, precisión balanceada | Falsas alarmas en intervalos vacíos | Precisión alta por clases desiguales |
| Gestos o actividades | Recall por clase, F1 macro, matriz de confusión | Clases o personas que se confunden | Informar solo de la clase fácil |
| Zona interior | Precisión de zona, F1 macro, error de distancia | Confusión entre zonas vecinas y deriva | Llamar coordenada precisa a una zona amplia |
| Estimación continua | MAE, error mediano, error percentil | Calidad del sensor de referencia y atípicos | Ocultar la distribución tras un promedio |
Crea un dataset que mida la generalización
Un modelo de sensado WiFi aprende las condiciones presentes en sus grabaciones. Si cada ventana de entrenamiento y prueba procede del mismo paseo, persona, habitación y minuto, las ventanas vecinas pueden compartir casi el mismo canal. La puntuación mide memorización, no generalización. Divide al nivel que corresponda a la afirmación: sesión, día, persona, habitación, distribución, o posición del nodo.
Empieza con un experimento pequeño y repetible. Captura una línea base vacía, etiqueta actividades o zonas con marcas de tiempo y conserva junto a la señal el canal, el ancho de banda, la orientación de antenas, el firmware y los cambios de la habitación. Una separación limpia vale más que una carpeta grande de CSI sin etiquetas.
- Usa una sesión separada para la puntuación final; no la uses para ajustar.
- Añade negativos: habitación vacía, persona quieta, pérdida de paquetes y movimiento de fondo.
- Si la afirmación es amplia, separa explícitamente una persona, habitación, día o distribución.
- Congela la partición antes de comparar filtros, atributos, modelos o umbrales.
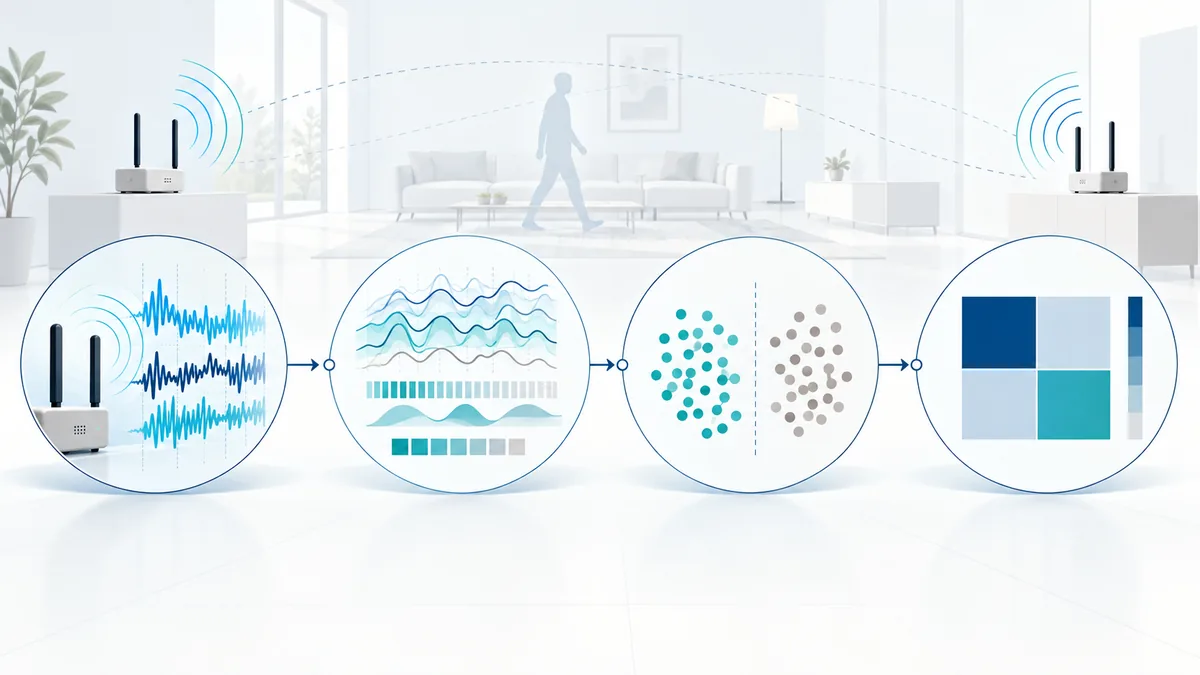
Una línea base desde CSI hasta una puntuación
Una línea base hace que la precisión sea auditable. Comienza con la ruta más sencilla que responda la pregunta: selección de paquetes, alineación temporal, limpieza básica, una ventana fija y un modelo transparente. Guarda el CSI original o mínimamente procesado para poder revisar un filtro. Si hace falta normalización, ajusta sus parámetros solo con la parte de entrenamiento.
Ejecuta después la misma ruta sobre datos separados y guarda predicciones con etiquetas. Conserva la matriz de confusión, el barrido de umbrales, la distribución de errores y ejemplos de predicciones equivocadas. Una línea base ligera puede revelar que la señal no es estable antes de que un modelo grande vuelva el informe más difícil de interpretar.
- Registra pérdida de paquetes, ventanas ausentes, saltos de tiempo y muestras rechazadas.
- Ajusta escala, selección de atributos y umbrales solo con entrenamiento.
- Guarda predicciones, etiquetas y cortes de error, no solo la puntuación final.
- Conserva la configuración junto al manifiesto del dataset.
Trampas que hacen que el resultado parezca más preciso
La trampa más común es la fuga de datos: una partición aleatoria permite que muestras vecinas de una grabación aparezcan en entrenamiento y prueba. El desequilibrio de clases, una persona fija o una habitación que se ordena entre clases también crean atajos. Sirven para depurar, no para una afirmación amplia.
El hardware y el entorno también derivan. Canal, ancho de banda, antenas, firmware, multitrayectoria, muebles, puertas, ventiladores, mascotas y tráfico ajeno pueden cambiar el CSI. Mide esa sensibilidad en vez de tratarla como una excepción incómoda.
| Trampa | Por qué infla la puntuación | Corrección |
|---|---|---|
| Ventanas aleatorias de una sesión | Muestras casi idénticas cruzan la partición | Reserva una sesión o día completo |
| Atajo de la clase mayoritaria | La clase rara pesa poco en la exactitud | Informa recall por clase, F1 macro y confusión |
| Atajo de persona o habitación | El modelo reconoce el entorno, no la tarea | Separa persona, habitación, distribución o nodo |
| Calibración no registrada | No se puede reproducir el umbral o la línea base | Versiona parámetros, ventana y reinicio |
Un protocolo práctico de validación
Para una primera prueba define cuatro pasos: línea base, evento controlado, repetición separada y cambio de condición. Registra el estado vacío, ejecuta el evento etiquetado varias veces, puntúa una sesión protegida y repite después de un cambio realista: otro día, otra persona, una silla movida o un reinicio. Así se ve si el modelo aprendió la señal o la grabación original.
Usa una plantilla breve: hardware y ruta de captura, geometría de nodos, clases, ventana, regla de partición, definiciones de métricas, umbral, mejores y peores casos y tratamiento de privacidad. Si el resultado es una visualización de investigación, describe su incertidumbre en lugar de inventar una precisión.
- Línea base: repite grabaciones vacías o neutrales y mide deriva.
- Evento: etiqueta una actividad, zona o estado con una referencia sincronizada.
- Repetición separada: ejecuta la ruta sin cambios en una sesión protegida.
- Cambio: prueba otro día, persona, distribución, canal o nodo.
- Informe: publica errores, exclusiones y condiciones donde no debe usarse.
Privacidad y límites de una afirmación de precisión
Una inferencia más precisa también puede revelar más sobre las personas. Ocupación, movimiento, rutina o señales respiratorias pueden ser sensibles aunque no se grabe vídeo. Pide consentimiento, limita la conservación, restringe el acceso al CSI y a las predicciones y explica qué se mide y qué se infiere. Una prueba de precisión no debe convertirse silenciosamente en vigilancia.
En RuView Blog, la precisión es una pregunta de investigación. Consulta las guías de CSI y dispositivos para la captura, y las de detección humana, posicionamiento o mapeo para los límites de cada tarea. Una demo que funciona no demuestra seguridad médica, de identidad o de seguridad física.
- Separa una puntuación del modelo de una afirmación sobre una persona o estado de salud.
- Documenta consentimiento, retención, eliminación y acceso a datos.
- Muestra confianza e incertidumbre cuando el resultado llega a usuarios.
- Detén la prueba si no existe una referencia adecuada para validar la afirmación.
Referencias técnicas y de investigación
Preguntas frecuentes sobre precisión WiFi sensing
¿Cuál es una buena precisión para WiFi sensing?
No existe una cifra universal. Un resultado útil declara tarea, etiquetas, equilibrio de clases, partición, métrica y condiciones. Una puntuación menor en una habitación separada puede ser más informativa que una cifra alta con ventanas vecinas de una sesión.
¿Cómo pruebo la precisión del sensado WiFi?
Define la salida, captura CSI etiquetado con una línea base, congela una sesión separada, ejecuta la misma ruta y publica una matriz de confusión o una distribución de errores. Añade una persona, habitación, día o nodo distinto si la afirmación debe generalizar.
¿Por qué mi modelo funciona en el laboratorio pero falla en casa?
Puede haber aprendido un atajo de habitación, persona, nodo, canal o sesión. Revisa fugas, deriva de calibración, muebles y multitrayectoria, pérdidas de paquetes y si la partición representa las condiciones de casa.
¿Puedo publicar una sola cifra de precisión para una demo?
Solo si existe una tarea definida, etiquetas de referencia, una partición documentada y una métrica adecuada. En otro caso describe el comportamiento, ejemplos y límites en vez de inventar un benchmark.
¿Una precisión alta hace seguro el WiFi sensing para medicina o seguridad?
No. Esos usos requieren validación específica, controles de riesgo, sistemas de referencia, revisión de privacidad y certificación cuando corresponda. Una puntuación de investigación no es una autorización.